 Simone
苹果传统强项再发力,视觉领域三种模态终于统一
的有关信息介绍如下:苹果在计算机视觉领域的传统强项上再次发力,研究团队提出了ATOKEN(A Unified Tokenizer for Vision),首次实现了图像、视频和三维资产的统一视觉分词,同时兼顾高保真重建与语义理解。这一成果标志着视觉领域向通用性与泛化能力迈出了重要一步。
视觉模态包含图像、视频和三维数据,三者具有不同的数据维度和表征方式:
传统研究中,三者通常需独立分词器,且分词器仅优化高保真重建(如细节还原)或语义理解(如分类、检索)之一,难以兼顾。
ATOKEN提出共享的稀疏4D潜在空间,将所有视觉模态表示为特征-坐标对集合:
优势:
ATOKEN采用纯Transformer架构,替代传统卷积方法,关键设计包括:
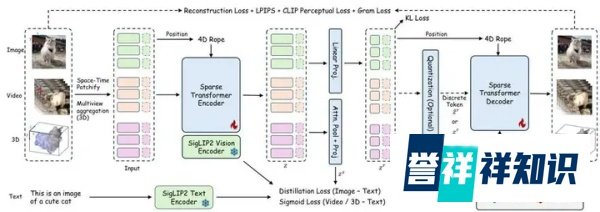
ATOKEN采用四阶段训练,逐步扩展模态能力:
关键结论:多模态训练不仅未削弱单一模态性能,反而通过跨模态信息共享增强了重建质量与语义理解。
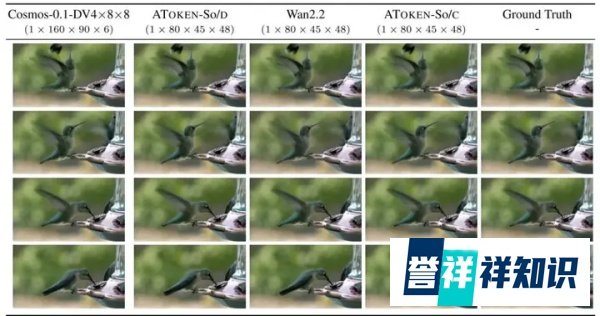
ATOKEN在图像、视频和三维任务上均达到业界领先水平:
ATOKEN的统一分词能力支持多模态生成与理解任务:
这一成果为下一代多模态AI系统奠定了基础,推动视觉领域向通用化、泛化性方向发展。